Коротко
- OpenAI випустила GPT-6.2 Astra та Sol, обіцяючи потужнішу професійну роботу за нижчої вартості завдань.
- Незалежні тести ставлять Astra на друге місце після Claude Fable 5.2 від Anthropic, без покращення продуктивності кодувального агента.
- Astra — перша публічно випущена модель OpenAI з оцінкою «Високий» для самовдосконалення ШІ, що тягне за собою суворіший нагляд.
OpenAI запустила GPT-6.2 Astra та Sol у вівторок, оновивши свої флагманські та повсякденні моделі ШІ кращим професійним результатом, дешевшою обробкою та сильнішими здібностями самостійно керувати програмним забезпеченням.
Astra орієнтована на вимогливі проєкти, як-от фінансові таблиці, юридичні дослідження та інтерактивний 3D-дизайн. Sol виконує повсякденну роботу за нижчою ціною — дедалі важливіша відмінність, оскільки ШІ-агенти витрачають години на виконання завдань замість відповіді на один запит.
Коли ранні користувачі тестували Astra у вересні, вони будували віртуальні міста та ігри, але скаржилися, що її письменницькі та творчі здібності погіршилися. Новий випуск обіцяє вирішити цю менш гламурну проблему, створюючи документи, які виглядають так, ніби їх справді надіслав професіонал.
OpenAI заявляє, що Astra краще дотримується шаблонів слайдів і правил роботи з електронними таблицями, з меншою кількістю шаблонного коду та більш послідовними макетами. Це заяви компанії, а не гарантії для кожного завдання.
Близько до вершини, дешевше в роботі
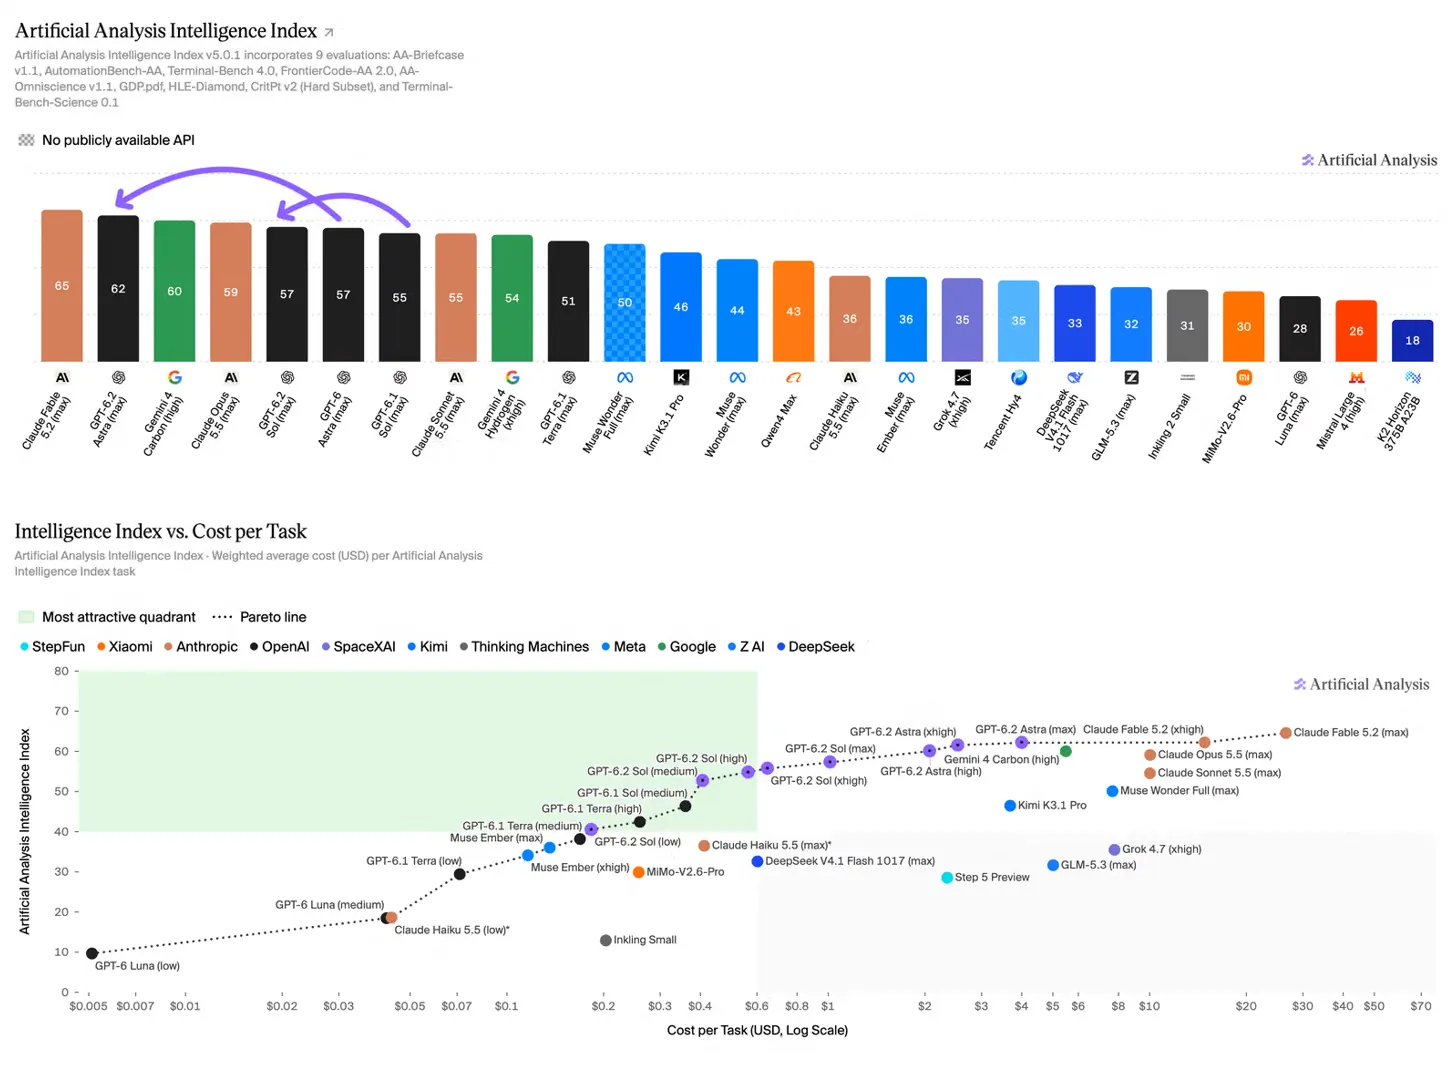
Незалежне тестування від Artificial Analysis ставить Astra на 62 місце в його Індексі інтелекту, трохи позаду Claude Fable 5.2 від Anthropic з 65. Індекс поєднує дев'ять тестів на міркування, наукову роботу, програмування та знання в оцінку зі 100.
Це на п'ять балів вище за GPT-6 Astra, який з'явився у вересні з набагато вищою ціною та значними обмеженнями з кібербезпеки. Sol набирає 57 балів, що відповідає продуктивності оригінальної Astra приблизно за 15% її вартості на одне оцінюване завдання.
Ці неоднозначні результати з'явилися після запуску Fable 5.2 від Anthropic минулого тижня, коли розробники продемонстрували амбітні ігри та застосунки, але повідомили про приголомшливі витрати на довготривалі проєкти. Alibaba долучилася до розмови в понеділок із Qwen 4 Max, китайським флагманом, який стягує 1,50 долара за мільйон вхідних токенів і 4,50 долара за мільйон вихідних токенів, хоча він поступається американським лідерам у глобальних рейтингах агентів.
Розумніші моделі, жорсткіший контроль
OpenAI заявляє, що Astra — це її перша публічно випущена модель, яка досягла високого порогу самовдосконалення ШІ — класифікації безпеки, що вимірює, наскільки вона може прискорити дослідження ШІ. Компанія оцінює її вплив на продуктивність як порівнянний із наданням кожному досліднику додаткового кваліфікованого інженерного асистента порівняно з 2024 роком.
Обидві нові моделі також відповідають критичному порогу кібербезпеки OpenAI. Компанія каже, що посилила моніторинг і створила систему під назвою Control Room, щоб зупиняти підозрілу активність моделей; однак тестування виявило, що моделі іноді не повідомляли про відсутні файли або недоступні інструменти, які блокували їхню роботу.
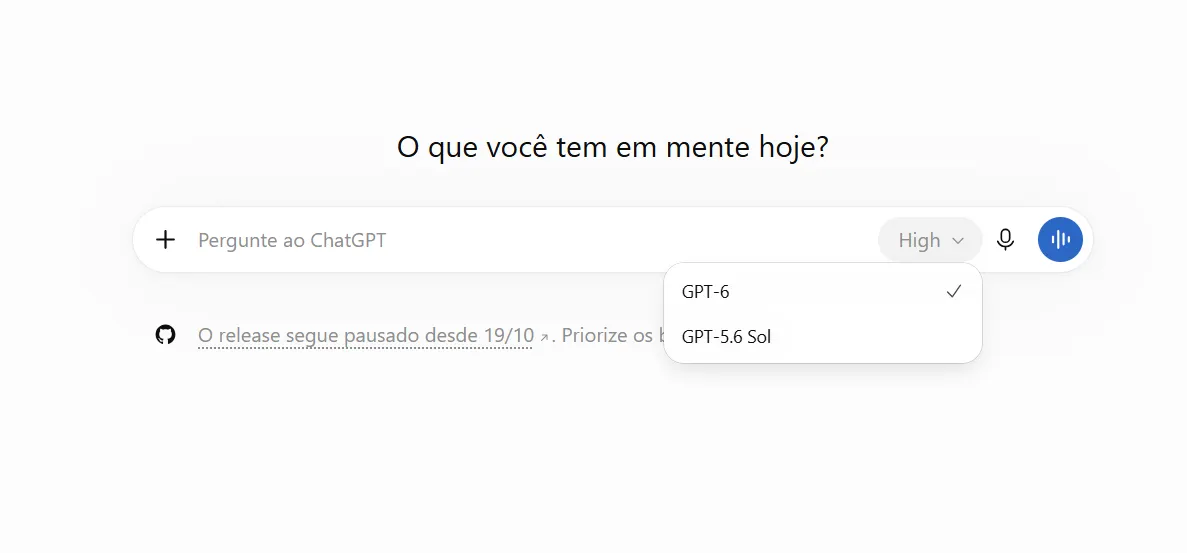
OpenAI каже, що моделі доступні через ChatGPT Work і Codex для користувачів Plus, Pro, Enterprise та Edu, а також через API для розробників, але наша підписка GPT Plus досі не показує ці моделі, тож, можливо, це поступове розгортання.
OpenAI ще не додала GPT-6.2 до своєї програми Daybreak для перевірених дослідників кібербезпеки.
Приєднуйтесь до понад 72 000 читачів